
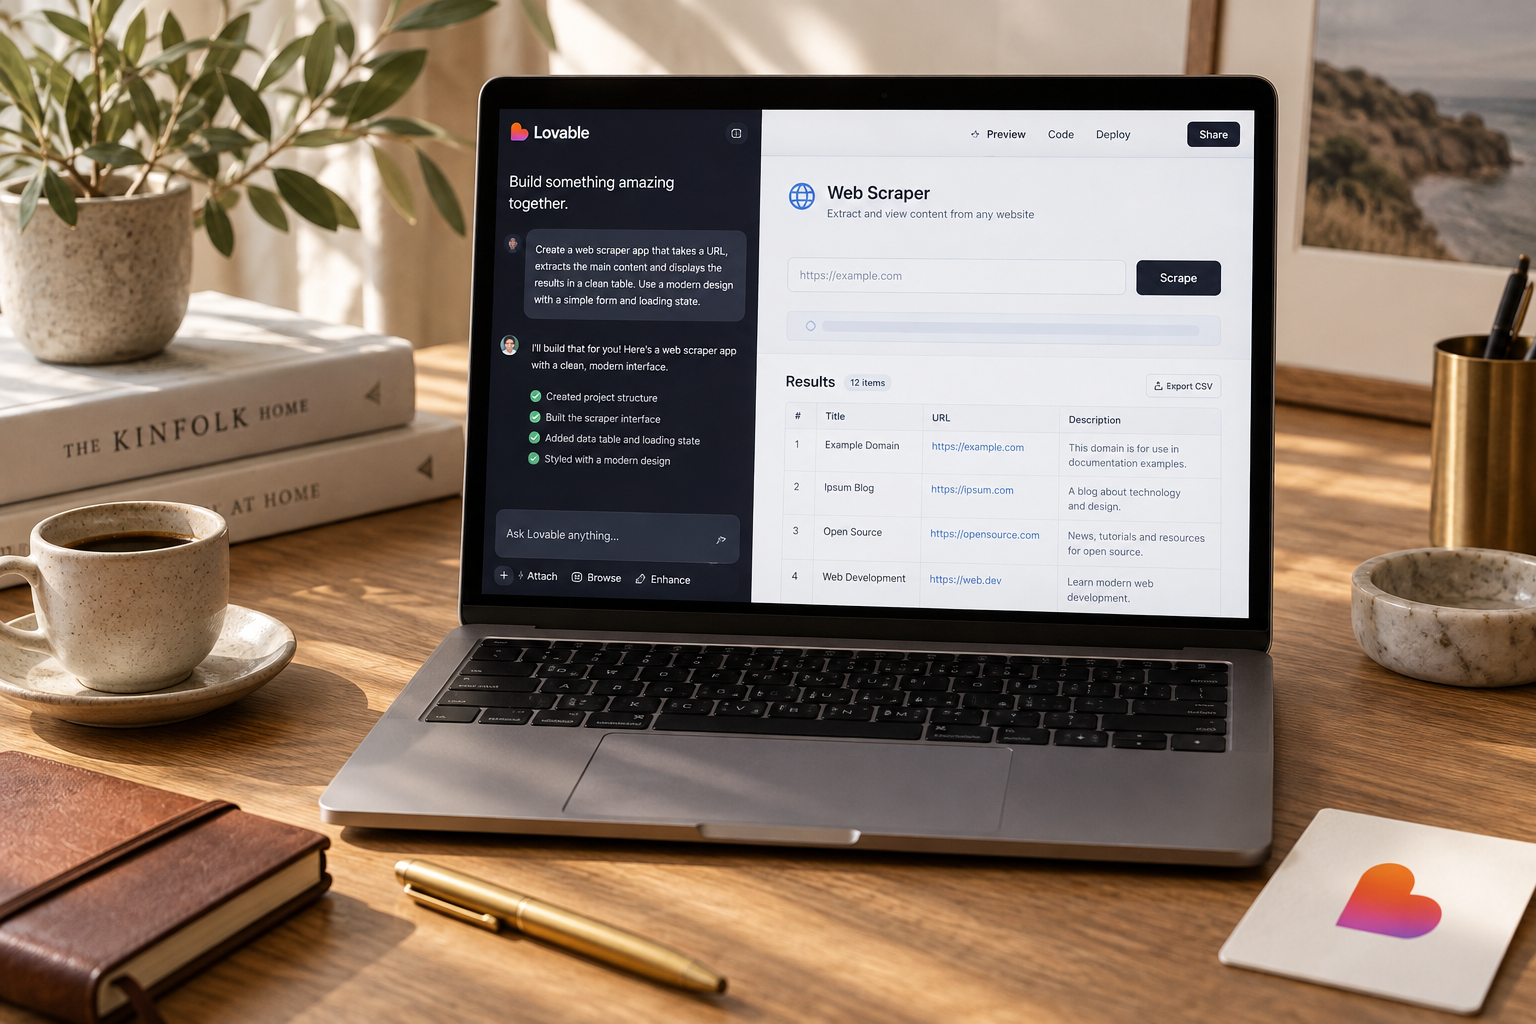
Use o Lovable para a interface, o Supabase para autenticação e armazenamento, e um serviço de scraping server-side para buscar páginas. Comece com uma URL aprovada por requisição, entregue resultados respaldados pela fonte original e controle o uso com cotas antes de adicionar crawling ou extração por IA.
Dá para criar um app de web scraping com o Lovable gerando a interface, conectando um backend no Supabase e chamando uma API de scraping a partir de uma função server-side. Deixe chaves de API e a lógica de requisição fora do navegador. Este tutorial constrói um scraper de página única com resultados salvos, exportação para CSV e limites que impedem uma ferramenta pequena de virar uma fatura astronômica.
O que você vai construir e quanto custa
Construa uma ferramenta de pesquisa, não uma plataforma de crawling genérica. Um usuário autenticado envia uma URL pública autorizada, recebe o título da página junto com o texto extraído e exporta os resultados anteriores.
Para a versão de outubro de 2026 deste tutorial, a stack usa Lovable, Supabase e Firecrawl. Planos de provedores e telas de integração mudam com frequência, então as instruções usam uma conexão explícita de API no backend em vez de depender de menus específicos do Lovable.
O caminho da requisição é direto:
`Navegador -> função de backend autenticada -> Firecrawl -> resultado salvo -> navegador`
O Lovable gera a aplicação. O Supabase cuida de contas, registros do banco de dados e da função de backend. O Firecrawl busca a página e converte o conteúdo em um formato utilizável. Você não precisa de um modelo de IA para extrair título e texto de página.
Mantenha a primeira versão propositalmente enxuta
Aceite apenas uma URL por envio. Restrinja o acesso a poucos testadores convidados. Permita somente domínios que você possui ou tem autorização para raspar.
Esqueça crawling recursivo, monitoramento agendado, páginas protegidas por login ou rotação de proxies por enquanto. Cada um desses itens transforma o problema operacional. Um scraper que funciona na sua documentação não vira automaticamente um produto confiável de monitoramento de concorrentes.
Se precisar de um caso de uso mais focado, explore a biblioteca de ideias de apps. Um inventário de documentação ou uma ferramenta de catálogo para fornecedores homologados é bem mais fácil de validar do que 'fazer scraping de tudo'.
Planeje tempo e orçamento antes dos prompts
Estas são estimativas de planejamento para um piloto pequeno, não cotações atuais de preços.
| Etapa de trabalho | Tempo estimado | Suposição de orçamento | |---|---|---| | Interface e autenticação | 45-90 minutos | Usa sua cota de geração do Lovable | | Banco de dados e integração backend | 90-180 minutos | Um piloto pequeno costuma caber nas cotas gratuitas | | Segurança, testes de falha e CSV | 90-180 minutos | Quase tudo tempo de implementação | | Uso de scraping | Varia por página | Reserve $5-$20 como orçamento de uso do piloto | | Total do primeiro piloto funcional | 4-8 horas | Planeje $30-$100 para o primeiro mês |
Quem está começando deve reservar um fim de semana. Valores mínimos cobrados, hospedagem, impostos ou sites de destino difíceis podem elevar os custos além dessa faixa. Consulte o guia de preços do Lovable e a página de cobrança atual de cada provedor antes de bater o martelo.
No planejamento de capacidade, 10 testadores fazendo 10 envios diários somam 3.000 requisições por mês. Isso não significa necessariamente 3.000 créditos faturáveis: renderização, novas tentativas e extrações opcionais alteram a métrica de cobrança do provedor.
Construa a interface e o banco de dados
Passo 1: Gere a menor aplicação útil possível
Crie um projeto no Lovable com especificações bem delimitadas. Evite pedir um 'dashboard corporativo de scraping'. Isso quase sempre entrega gráficos decorativos antes mesmo de você ter uma requisição funcionando.
Cole este prompt:
```text Build an authenticated single-page web scraper app called Page Ledger.
Use Supabase for authentication, database storage, and a server-side Edge Function. Do not call the scraping provider from the browser.
Screens:
- Sign in.
- Dashboard with one HTTPS URL input and a Scrape page button.
- Results table with URL, title, status, and creation date.
- Result detail with extracted Markdown and a source link.
Create a scrape_jobs table with: id, user_id, requested_url, final_url, status, title, markdown, error_code, created_at, completed_at.
Requirements:
- Users can read only their own jobs using row-level security.
- The server assigns ownership from the verified user session.
- Provider credentials stay in backend secrets.
- Only exact hostnames in a server-managed allowlist are accepted.
- Start with one active job per user and 10 submissions per day.
- Enforce quotas atomically on the server.
- Show queued, running, succeeded, failed, and timed_out states.
- Never claim success using mock data.
- Add CSV export for the signed-in user's results.
- Render extracted content safely, with raw HTML disabled.
First implement the schema, access policies, and UI. Before adding the provider call, explain the authentication flow, secret storage, and proposed quota enforcement for review. ```
Divida o desenvolvimento em etapas fáceis de revisar. A biblioteca de prompts traz outros padrões para manter pedidos de ajuste sob controle.
Passo 2: Conecte o Supabase e confira a posse dos dados
Conecte o projeto correto do Supabase pelo fluxo de integração oficial do Lovable. Confirme o identificador do projeto antes de rodar qualquer migration. Usar acidentalmente um banco de dados de produção é um atalho perigoso.
Trate as políticas geradas como código que exige testes rigorosos.
O campo `scrape_jobs.user_id` precisa referenciar um usuário autenticado. Ative o row-level security e libere leituras apenas quando o dono da linha bater com o usuário logado.
Nessa arquitetura, o navegador não cria nem atualiza jobs diretamente. O backend valida o token da sessão, define a posse por conta própria e grava o estado da tarefa. Jamais confie em um `user_id` enviado no corpo da requisição HTTP.
Se o backend utilizar uma credencial de banco com privilégios administrativos, lembre-se de que ela ignora o row-level security. Toda leitura ou escrita feita por esse cliente precisa validar a posse explicitamente. Nunca deixe essa credencial vazar para variáveis de ambiente ou bundles do frontend.
Passo 3: Torne os estados das tarefas informativos
Gere o registro do job antes de disparar a chamada ao Firecrawl. Isso garante que eventuais erros fiquem gravados, em vez de sumirem em um alerta temporário na tela.
Grave códigos de erro fáceis de entender, como `DOMAIN_NOT_ALLOWED`, `RATE_LIMITED`, `FETCH_FAILED` e `PROVIDER_TIMEOUT`. Mantenha os detalhes técnicos do provedor em logs protegidos, nunca na resposta entregue ao cliente.
Atribua o status `timed_out` a requisições que estourarem o tempo limite síncrono. Não deixe o usuário esperando infinitamente.
Conecte o scraper com segurança
Passo 4: Guarde a credencial do provedor
Gere uma chave de API no Firecrawl e salve como secret no backend, usando um identificador como `FIRECRAWL_API_KEY`. Acesse esse valor apenas dentro da função do servidor.
Não cole uma chave ativa no chat do Lovable. Não coloque esse segredo em variáveis expostas ao navegador, como `VITE_FIRECRAWL_API_KEY`. Se a chave parar em um arquivo JavaScript gerado no build, considere que qualquer visitante já tem acesso a ela.
A API v2 de scrape do Firecrawl adota a estrutura abaixo. Confirme a sintaxe na documentação oficial antes de colocar em produção:
```http POST https://api.firecrawl.dev/v2/scrape Authorization: Bearer YOUR_SERVER_SIDE_KEY Content-Type: application/json
{ "url": "https://your-approved-domain.example/docs/start", "formats": ["markdown"], "onlyMainContent": true } ```
Substitua a URL do exemplo por uma página autorizada. Uma resposta padrão de sucesso devolve o Markdown extraído em `data.markdown` e os metadados em `data.metadata`. Trate casos de metadados ausentes, texto vazio, falhas do provedor e retornos que não venham em JSON.
Grave o título sempre que ele estiver disponível. Guarde a URL final validada quando o provedor fornecer esse dado; caso contrário, deixe o campo vazio em vez de assumir que a URL digitada foi o destino definitivo.
Passo 5: Valide as URLs antes de gastar créditos
O backend deve processar estas verificações em sequência:
- Validar o token do usuário logado.
- Fazer o parse da URL com um parser próprio, nunca apenas com expressões regulares.
- Exigir HTTPS e barrar logins ou senhas embutidos na URL.
- Bloquear endereços de IP diretos e portas fora do padrão.
- Conferir o hostname normalizado contra uma allowlist exata gerenciada no servidor.
- Reservar a cota e o slot de job ativo do usuário de forma atômica.
- Criar a tarefa e disparar a chamada para a API externa.
- Salvar o conteúdo ou registrar o erro, liberando o slot de job ativo.
Evite validações frouxas de sufixo. Liberar `example.com` não pode abrir brecha para `notexample.com`. No piloto, adicione subdomínios um a um.
Montar uma allowlist de hostnames é indispensável, mas não elimina todos os riscos de Server-Side Request Forgery. Redirecionamentos e alterações de DNS podem desviar a requisição para locais perigosos. A camada de rede precisa bloquear acessos a loopback, redes privadas, link-local e metadados de provedores de nuvem em qualquer salto de redirecionamento.
Ao usar um scraper gerenciado, confirme se essas defesas já estão ativas no serviço. Se houver dúvida sobre essas travas, não libere a inserção de URLs arbitrárias para o público. Mantenha o piloto restrito a domínios sob seu controle e sem redirecionamentos manipuláveis pelo usuário. Olhar a URL final depois que a raspagem aconteceu não impede o ataque.
Passo 6: Defina limites invioláveis pelo navegador
Adote estas travas iniciais no app:
- Uma requisição ativa por usuário.
- Dez envios diários por conta.
- Limite de 30 segundos por requisição, se a plataforma do backend permitir.
- Teto de 200.000 caracteres de texto armazenados por página.
- Nenhuma tentativa automática de reenvio nesta primeira versão.
Essas regras são limites do seu produto, não da API externa. Desconte envios aceitos da cota mesmo se a extração falhar, caso contrário repetições contínuas de erro podem gerar custos descontrolados.
Aplique a reserva em uma transação no banco de dados ou por meio de operação atômica equivalente. Duas requisições simultâneas não podem encontrar o mesmo slot vago ao mesmo tempo.
Configure um timeout no provedor menor do que o tempo limite do seu backend. Abortar a chamada HTTP no seu código não garante que o provedor parou de processar ou de cobrar. Registre jobs expirados e evite disparar novas tentativas sem intervenção manual.
Para sites pesados, migre a operação para filas em background mais adiante. Não tente mascarar uma integração síncrona instável com telas de carregamento intermináveis.
Teste, exporte e lance
Passo 7: Teste o comportamento, não só o visual da tela
Crie uma página de teste simples em um domínio próprio com título, parágrafo e link conhecidos. Valide se a extração traz esses elementos exatos e mantém o link original apontando para a fonte.
Depois, execute esta bateria de testes:
| Teste | Resultado esperado | |---|---| | Página pública aprovada | Resultado salvo com o conteúdo extraído real | | Hostname desconhecido | Rejeitado antes de chamar o provedor | | URL com credenciais embutidas | Rejeitada antes de chamar o provedor | | Endereço IP privado | Rejeitado antes de chamar o provedor | | Décimo primeiro envio do dia | Erro de cota sem disparar chamada externa | | Dois envios simultâneos | Apenas uma requisição aceita por vez | | Usuário B acessa dados do Usuário A | Acesso negado ao registro | | Provedor retorna erro ou trava | Tarefa marcada como falha ou timeout, com mensagem clara |
Teste também um redirecionamento dentro de um domínio sob seu controle. Certifique-se de que a camada de requisição valida as restrições no destino final, e não apenas no endereço inicial.
Receber um status HTTP 200 não significa que o scraping deu certo. Telas com CAPTCHA, páginas de login ou respostas em branco não devem ser salvas como dados úteis. Exiba um alerta sempre que o texto extraído falhar nas checagens básicas de qualidade.
Passo 8: Exporte os dados com segurança
Comece exportando `requested_url`, `title`, `status` e `created_at`. Deixe o texto completo em Markdown visível na tela de detalhes até que os usuários peçam exportações em massa de conteúdo.
Adote uma biblioteca de CSV que lide de forma correta com aspas, vírgulas e quebras de linha. Remova ou sanitize prefixos de fórmulas de planilhas como `=`, `+`, `-` e `@`, cobrindo casos disfarçados por espaços em branco ou caracteres de controle. Envolver a célula em aspas não impede planilhas de executarem fórmulas maliciosas.
Trate qualquer conteúdo raspado como dado não confiável. Desative a renderização de tags HTML brutas no Markdown ou processe o texto com um sanitizer atualizado. Nunca insira o HTML retornado direto no DOM da aplicação.
Passo 9: Conduza um piloto controlado
Chame cinco pessoas para testar e peça a cada uma para extrair dados de cinco páginas autorizadas. Analise as 25 execuções. Acompanhe a taxa de sucesso útil, o tempo de resposta, o consumo da API e os motivos de eventuais falhas.
Uma meta razoável para lançamento é alcançar pelo menos 23 resultados válidos em 25 tentativas, com zero incidentes de vazamento entre contas. Essa régua serve para homologação, não como garantia de desempenho futuro. Investigue falhas de segurança imediatamente, independentemente da taxa geral de sucesso.
Antes de abrir o app para mais pessoas, revise esta lista:
- [ ] Nenhuma credencial de provedor ou chave administrativa do banco aparece nos assets públicos do navegador.
- [ ] Autenticação e isolamento de dados foram validados usando duas contas distintas.
- [ ] Restrições de hostname, regras de redirecionamento e limites de uso estão funcionando.
- [ ] Timeouts encerram os jobs em estados definitivos.
- [ ] Conteúdo raspado e arquivos CSV passam por higienização segura.
- [ ] Usuários conseguem apagar dados salvos, com política clara de retenção.
- [ ] Alertas de consumo da API e botão de emergência para desligar o app estão ativos.
- [ ] Domínios do piloto foram aprovados e os usos proibidos estão documentados.
Coloque essa versão no ar antes de pensar em crawling completo. Entregar estabilidade em cinco sites homologados vale muito mais do que prometer um painel que raspa a web inteira.
O Lovable consegue fazer scraping sem uma API externa?
Sim. O Lovable pode gerar código para fetchers customizados no servidor ou scripts de automação de navegadores. Buscar páginas direto pelo navegador esbarra em restrições de CORS, e sites dinâmicos costumam exigir renderização via headless browser. Contratar uma API especializada poupa trabalho de infraestrutura, mas não resolve questões de permissão ou acesso aos dados.
É legal criar um web scraper usando o Lovable?
Construir a ferramenta é diferente de ter autorização para coletar e reaproveitar dados de terceiros. Verifique leis locais, termos de uso dos sites, obrigações de privacidade e direitos autorais. Respeite as diretrizes de robots e bloqueios de acesso, lembrando que o robots.txt não funciona como autorização jurídica. Comece sempre com dados próprios ou com permissão expressa.
Como incluir extração com IA no scraper?
Insira uma etapa dedicada no backend logo após o download da página. Defina um schema rígido para o modelo, exija citações do texto de origem para validar as respostas e force o retorno de `null` em campos não encontrados. Nunca trate comandos presentes no texto raspado como instruções para a aplicação executar ferramentas. Monitore os gastos do modelo separados dos custos da API de scraping.
O Briefing
O melhor do Lovable, uma vez por semana.
Análises a fundo, casos de fundadores e táticas de crescimento. Sem enrolação.
Sem spam. Cancelamento com um clique.
Crie algo com a gente
Começar com o Lovable
Abra o Lovable, escreva seu primeiro prompt e lance aquilo em que você já pensa faz tempo demais.
Começar com o Lovable