
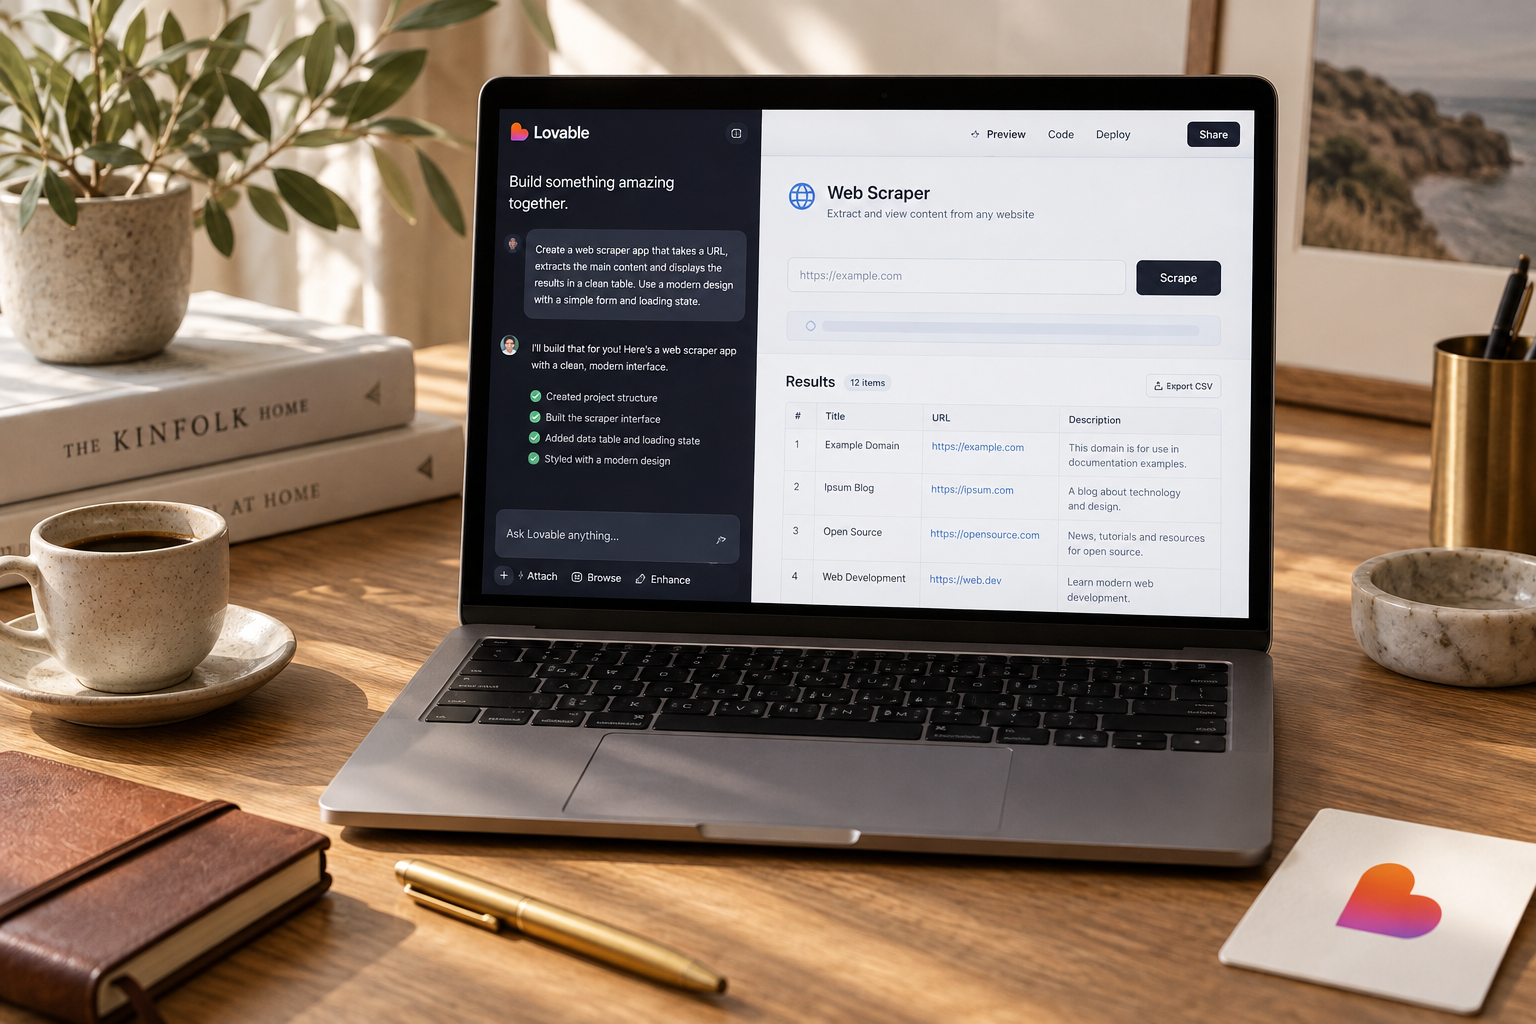
Используйте Lovable для интерфейса, Supabase для аутентификации и хранения, а серверный сервис скрапинга - для загрузки страниц. Начните с одного проверенного URL на запрос, отдавайте результаты с привязкой к первоисточнику и настройте квоты, прежде чем подключать краулинг или AI-экстракцию.
Веб-скрейпер на Lovable можно собрать в три шага: сгенерировать интерфейс, подключить бэкенд на Supabase и вызывать API скрейпинга из серверной функции. Ключи API и логику запросов нельзя оставлять в браузере. В этом руководстве мы создадим одностраничный скрейпер с сохранением результатов, экспортом в CSV и лимитами, которые не позволят маленькой утилите превратиться в огромный счет за инфраструктуру.
Что получится в итоге и сколько это стоит
Собираем инструмент для точечного ресерча, а не универсальную краулинг-платформу. Авторизованный пользователь отправляет один разрешенный публичный URL, получает заголовок страницы и извлеченный текст, а также может скачивать историю результатов.
Для версии руководства за октябрь 2026 года стек выглядит так: Lovable, Supabase и Firecrawl. Тарифы провайдеров и экраны интеграций постоянно меняются, поэтому мы настроим прямое серверное подключение к API, а не будем полагаться на конкретные кнопки в меню Lovable.
Путь запроса предельно простой:
`Browser -> authenticated backend function -> Firecrawl -> saved result -> browser`
Lovable собирает приложение. Supabase отвечает за аккаунты, записи в базе данных и серверную функцию. Firecrawl скачивает страницу и превращает ее содержимое в удобный формат. Чтобы вытащить заголовок и текст страницы, AI-модель не нужна.
Первая версия должна быть намеренно минималистичной
Один запрос - один URL. Ограничьте доступ несколькими приглашенными тестировщиками. Разрешите сбор только с тех доменов, которыми владеете сами или на которые получили прямое разрешение.
Не добавляйте рекурсивный обход страниц, регулярный мониторинг по расписанию, поддержку страниц с авторизацией или ротацию прокси. Каждая из этих задач кардинально усложняет проект. Скрейпер, который отлично вытягивает данные из вашей документации, не превратится сам по себе в надежный сервис для слежки за конкурентами.
Если нужен более узкий сценарий, загляните в библиотеку идей для приложений. Инструмент для инвентаризации документации или каталога проверенных поставщиков проверить на практике куда проще, чем концепт "скрейпинг всего интернета".
Спланируйте время и бюджет до написания промптов
Это ориентировочные оценки для небольшого пилота, а не актуальный прайс-лист сервисов.
| Задача | Примерное время | Расчет бюджета | |---|---|---| | Интерфейс и авторизация | 45-90 минут | Расходует лимит сборок Lovable | | База данных и интеграция бэкенда | 90-180 минут | Небольшой пилот может уложиться в бесплатные лимиты | | Безопасность, тесты на сбои и CSV | 90-180 минут | В основном время на разработку | | Расходы на скрейпинг | Зависит от страниц | Заложите $5-$20 на пилотное тестирование | | Итого для первого рабочего пилота | 4-8 часов | Рассчитывайте на $30-$100 в первый месяц |
Новичку лучше заложить на это выходные. Минимальные платные тарифы, хостинг, налоги или сложный целевой сайт могут увеличить итоговую сумму. Прежде чем начинать, проверьте руководство по ценам Lovable и страницы с тарифами каждого провайдера.
Для оценки емкости: 10 тестировщиков, делающих по 10 запросов в день, дают 3 000 запросов в месяц. Но это не обязательно 3 000 оплачиваемых кредитов: рендеринг, повторные попытки и извлечение данных могут расходовать больше единиц тарификации.
Создаем интерфейс и базу данных
Шаг 1: Сгенерируйте минимально полезное приложение
Создайте проект в Lovable и задайте ему четкие рамки. Не просите "enterprise-дашборд для скрейпинга". Обычно в ответ вы получите декоративные графики задолго до того, как заработает первый реальный запрос.
Вставьте этот промпт:
```text Build an authenticated single-page web scraper app called Page Ledger.
Use Supabase for authentication, database storage, and a server-side Edge Function. Do not call the scraping provider from the browser.
Screens:
- Sign in.
- Dashboard with one HTTPS URL input and a Scrape page button.
- Results table with URL, title, status, and creation date.
- Result detail with extracted Markdown and a source link.
Create a scrape_jobs table with: id, user_id, requested_url, final_url, status, title, markdown, error_code, created_at, completed_at.
Requirements:
- Users can read only their own jobs using row-level security.
- The server assigns ownership from the verified user session.
- Provider credentials stay in backend secrets.
- Only exact hostnames in a server-managed allowlist are accepted.
- Start with one active job per user and 10 submissions per day.
- Enforce quotas atomically on the server.
- Show queued, running, succeeded, failed, and timed_out states.
- Never claim success using mock data.
- Add CSV export for the signed-in user's results.
- Render extracted content safely, with raw HTML disabled.
First implement the schema, access policies, and UI. Before adding the provider call, explain the authentication flow, secret storage, and proposed quota enforcement for review. ```
Разделяйте разработку на небольшие этапы, которые легко проверить. В библиотеке промптов есть готовые шаблоны, помогающие удерживать фокус в последующих запросах.
Шаг 2: Подключите Supabase и проверьте разграничение доступа
Подключите нужный проект Supabase через штатную интеграцию в Lovable. Обязательно сверьте идентификатор проекта перед накатыванием миграций. Случайно привязать продакшен-базу - слишком дорогая ошибка.
Относитесь к сгенерированным политикам безопасности как к коду, требующему обязательного тестирования.
Поле `scrape_jobs.user_id` должно ссылаться на авторизованного пользователя. Включите Row-Level Security и разрешайте чтение только в том случае, если владелец строки совпадает с текущим пользователем.
По этой архитектуре браузер не создает и не обновляет задачи напрямую. Бэкенд валидирует токен пользователя, сам назначает владельца и фиксирует статус задачи. Никогда не доверяйте `user_id`, переданному в теле запроса.
Если бэкенд использует сервисный ключ базы данных с повышенными правами, помните: он обходит Row-Level Security. Любое чтение или обновление через такой клиент обязано явно проверять права владельца. Никогда не помещайте этот ключ в переменные окружения фронтенда или клиентский бандл.
Шаг 3: Сделайте статусы информативными
Создавайте задачу в базе до отправки запроса в Firecrawl. Так ошибки останутся зафиксированными, а не пропадут бесследно за всплывающим уведомлением.
Сохраняйте понятные коды ошибок, например `DOMAIN_NOT_ALLOWED`, `RATE_LIMITED`, `FETCH_FAILED` и `PROVIDER_TIMEOUT`. Подробные диагностические логи от провайдера держите в закрытых логах сервера, а не в ответе клиенту.
Используйте статус `timed_out`, если запрос превысил лимит ожидания. Не оставляйте задачи вечно висеть в процессе выполнения.
Безопасное подключение скрейпера
Шаг 4: Добавьте ключ провайдера
Сгенерируйте API-ключ Firecrawl и сохраните его в секретах бэкенда, например под именем `FIRECRAWL_API_KEY`. Считывайте его исключительно внутри серверной функции.
Не вставляйте рабочий ключ в чат Lovable. Не записывайте его в переменные, доступные браузеру, вроде `VITE_FIRECRAWL_API_KEY`. Если ключ попал в собранный JavaScript-бандл, считайте, что его уже скопировали.
API скрейпинга Firecrawl v2 принимает запросы в таком формате. Перед развертыванием сверьтесь со свежей документацией сервиса:
```http POST https://api.firecrawl.dev/v2/scrape Authorization: Bearer YOUR_SERVER_SIDE_KEY Content-Type: application/json
{ "url": "https://your-approved-domain.example/docs/start", "formats": ["markdown"], "onlyMainContent": true } ```
Замените тестовый URL на разрешенную страницу. При успешном ответе сервис возвращает извлеченный Markdown в поле `data.markdown` и метаданные страницы в `data.metadata`. Обязательно предусмотрите обработку пустых метаданных, пустого контента, сбоев провайдера и ответов не в формате JSON.
Сохраняйте заголовок, если он есть. Записывайте подтвержденный финальный URL, если провайдер его передает. Если нет - лучше оставить поле пустым, чем делать вид, что отправленный пользователем URL и был конечной точкой.
Шаг 5: Валидируйте URL до того, как потратите кредиты
Бэкенд должен выполнять следующие проверки строго по порядку:
- Проверить токен авторизованного пользователя.
- Разобрать URL штатным парсером, а не просто регулярным выражением.
- Требовать протокол HTTPS и отклонять адреса со встроенными логинами или паролями.
- Отклонять прямые IP-адреса и нестандартные порты.
- Сверить нормализованный хост с точным белым списком на сервере.
- Атомарно зарезервировать квоту пользователя и слот для активной задачи.
- Создать задачу и выполнить запрос к провайдеру.
- Сохранить результат или ошибку и освободить слот активной задачи.
Не используйте нестрогую проверку по суффиксу. Разрешая `example.com`, вы не должны случайно открыть доступ к `notexample.com`. Для пилота прописывайте каждый поддомен отдельно.
Белый список хостов необходим, но он не защищает от всех угроз SSRF (подделки запросов на стороне сервера). Редиректы и изменения DNS могут перенаправить запрос по неожиданному адресу. Сетевой уровень обязан блокировать обращения к loopback, локальным, link-local и адресам метаданных облачных провайдеров на каждом редиректе и каждом разрешении DNS.
При работе с облачным скрейпером убедитесь, что эти механизмы защиты есть у провайдера. Если механизмы контроля вызывают сомнения, не открывайте прием произвольных URL для всех подряд. Ограничьте пилот доменами, которые вы контролируете, исключив пользовательские редиректы. Проверка финального URL уже после выполнения запроса защитой не является.
Шаг 6: Задайте лимиты, которые нельзя обойти через браузер
Задайте базовые ограничения приложения:
- Один активный запрос на пользователя.
- Не более 10 запросов на пользователя в сутки.
- Таймаут приложения в 30 секунд (если позволяет среда выполнения функций).
- Максимум 200 000 символов текста на один сохраненный результат.
- Никаких автоматических повторных попыток в первой версии.
Это правила на уровне самого продукта, а не лимиты провайдера. Считайте принятые запросы в счет дневной квоты, даже если парсинг завершился ошибкой. Иначе серия сбоев превратится в бесконечный поток платных запросов.
Фиксируйте резервирование слота в транзакции базы данных или аналогичной атомарной операции. Ситуация, когда два параллельных запроса видят свободный слот и одновременно уходят в работу, недопустима.
Если возможно, выставляйте таймаут у провайдера меньше, чем лимит времени выполнения вашей серверной функции. Обрыв HTTP-соединения с вашей стороны не гарантирует, что провайдер прекратит обработку и не спишет деньги. Фиксируйте задачи с таймаутом и не перезапускайте их вслепую.
Медленные страницы в будущем лучше вынести в фоновую очередь. Не пытайтесь маскировать нестабильную синхронную интеграцию длинной анимацией загрузки.
Тестирование, экспорт и запуск
Шаг 7: Тестируйте поведение, а не только внешний вид
Подготовьте тестовую статическую страницу на своем домене с известным заголовком, абзацем и ссылкой. Убедитесь, что полученный результат содержит именно эти данные и ссылается на исходный адрес.
Затем прогоните этот тестовый сценарий:
| Тест | Ожидаемый результат | |---|---| | Разрешенная публичная страница | Сохраненный результат с реальным контентом | | Неизвестный хост | Отклонен до вызова провайдера | | URL с логином и паролем | Отклонен до вызова провайдера | | Приватный IP-адрес | Отклонен до вызова провайдера | | Одиннадцатый запрос за день | Ошибка превышения квоты без вызова провайдера | | Два одновременных запроса | Запускается только одна активная задача | | Пользователь B запрашивает результат пользователя A | Доступ к записи заблокирован | | Провайдер вернул ошибку или завис | Статус failed или timed_out с понятным описанием |
Проверьте также редирект на контролируемом вами домене. Убедитесь, что сетевой слой применяет ограничения к конечному адресу, а не только к исходному хосту.
Успешный HTTP-ответ сам по себе не доказывает, что данные собраны корректно. Страница с капчей, форма логина или пустой документ не должны превращаться в "успешный" результат парсинга. Выводите предупреждение, если полученный контент не проходит базовую проверку на валидность.
Шаг 8: Настройте безопасный экспорт
Начните с экспорта полей `requested_url`, `title`, `status` и `created_at`. Полный текст в Markdown пока оставляйте на детальной странице, пока пользователям действительно не понадобится массовая выгрузка всего контента.
Используйте библиотеку для работы с CSV, которая корректно обрабатывает кавычки, запятые и переносы строк. Нейтрализуйте префиксы формул электронных таблиц, такие как `=`, `+`, `-` и `@`, включая случаи, когда они спрятаны за пробелами или управляющими символами. Простого оборачивания ячейки в кавычки недостаточно, чтобы предотвратить выполнение формул.
Всегда относитесь к спарсенному контенту как к недоверенным данным. Отключите отображение сырого HTML при рендеринге Markdown или очищайте его проверенным санитайзером. Никогда не вставляйте полученный HTML напрямую в DOM.
Шаг 9: Запустите контролируемый пилот
Пригласите пять тестировщиков и попросите каждого спарсить по пять разрешенных страниц. Проверьте все 25 попыток. Зафиксируйте процент полезных результатов, время ответа, расход кредитов у провайдера и причины сбоев.
Ориентир для запуска: минимум 23 успешных результата из 25 и полное отсутствие межпользовательских утечек данных. Это критерии приемки, а не гарантия будущей производительности. Любой сбой в безопасности требует немедленного разбора, независимо от общего процента успеха.
Перед тем как делиться приложением, пройдитесь по чек-листу:
- [ ] Ключи провайдера и сервисные ключи базы данных отсутствуют в клиентских бандлах.
- [ ] Аутентификация и изоляция данных проверены на двух независимых аккаунтах.
- [ ] Ограничения по хостам, защита от небезопасных редиректов и квоты протестированы.
- [ ] Таймауты переводят задачи в финальный статус.
- [ ] Спарсенный контент и экспорт в CSV обрабатываются безопасно.
- [ ] Пользователи могут удалять сохраненные данные, срок хранения задокументирован.
- [ ] Настроены оповещения о расходе лимитов провайдера и аварийное отключение (kill switch).
- [ ] Список пилотных доменов утвержден, запрещенные сценарии зафиксированы.
Запустите эту версию до того, как браться за полноценный краулинг. Стабильная работа на пяти разрешенных сайтах ценнее, чем красивый дашборд с неработающими обещаниями парсить весь интернет.
Может ли Lovable парсить сайты без стороннего API?
Да. Lovable может сгенерировать код для собственного серверного загрузчика или скрипта автоматизации браузера. Но запросы только из браузера быстро упрутся в ограничения CORS, а динамическим страницам нужен рендеринг. Готовый сервис скрейпинга избавляет от возни с инфраструктурой, но не гарантирует доступность сайтов или юридическое право на сбор данных.
Законно ли создавать скрейпер на Lovable?
Создание самого инструмента не означает наличия прав на сбор и повторное использование данных конкретного сайта. Изучите законодательство, правила использования ресурса, требования к защите персональных данных и авторские права. Соблюдайте директивы robots.txt и технические ограничения, но помните, что robots.txt не дает юридического разрешения. Начинайте со своих данных или получайте прямое согласие владельцев.
Как добавить извлечение данных с помощью AI?
Добавьте отдельный серверный шаг после успешного получения страницы. Передайте модели строгую схему данных, требуйте цитирования исходного текста и возвращайте `null` для отсутствующих полей. Относитесь к спарсенным инструкциям как к ненадежным данным и ни в коем случае не давайте модели выполнять из них вызовы инструментов. Считайте расходы на модель отдельно от стоимости скрейпинга.
Рассылка
Лучшее о Lovable раз в неделю
Глубокие разборы, кейсы основателей и тактика роста. Без шума.
Никакого спама. Отписка в один клик.
Создавайте вместе с нами
Начать создавать с Lovable
Откройте Lovable, напишите первый промпт и запустите то, о чём давно думали.
Начать создавать с Lovable